Data open source pour LLM : choisir son corpus avant son modèle
Pour exploiter de la data open source pour LLM, commencez par distinguer les données qui servent à entraîner le modèle de celles qu’il consulte pour répondre. Un corpus ouvert peut alimenter un apprentissage, enrichir un assistant documentaire ou mesurer sa fiabilité. Mais sa disponibilité ne garantit ni sa qualité ni le droit de le réutiliser. Le bon point de départ reste donc votre usage, puis la provenance et la licence des données.
Données ouvertes et modèle ouvert : deux choix indépendants
Un LLM, ou grand modèle de langage, apprend des régularités à partir de grandes quantités de texte. Il peut ensuite générer, résumer, traduire ou analyser des contenus. Les données utilisées pendant cet apprentissage influencent ses capacités, sans constituer une base documentaire qu’il restituerait fidèlement à chaque question.
L’expression « données open source » désigne souvent, par commodité, des données ouvertes ou open data. Pour un corpus, les questions essentielles portent sur l’accès, la licence, la provenance et les conditions de redistribution. Pour un modèle, il faut examiner séparément le code, les poids téléchargeables, la documentation et les informations publiées sur l’entraînement.
Des poids accessibles ne signifient pas que les données d’entraînement sont ouvertes. L’étiquette « LLM open source » recouvre ainsi des degrés de transparence variables. À l’inverse, un corpus ouvert peut être utilisé avec un modèle propriétaire, sous réserve des licences et des conditions du service.
| Type de données | Rôle | Limite principale |
|---|---|---|
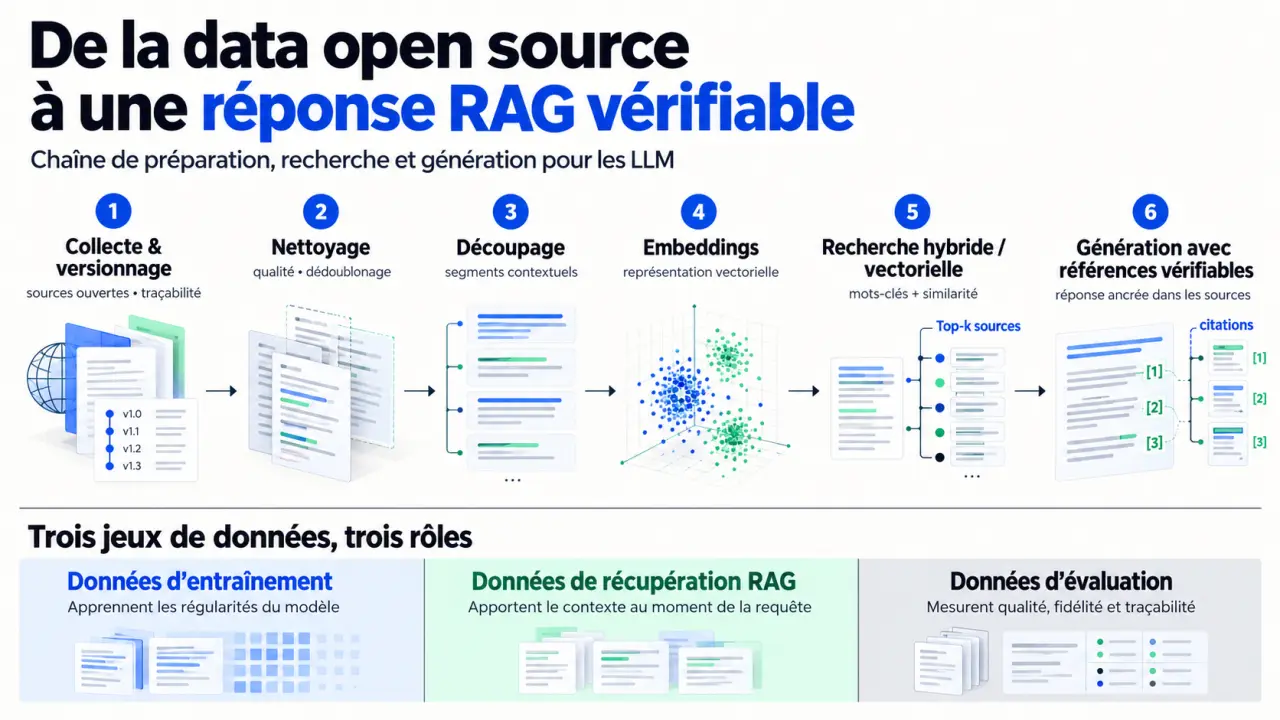
| Entraînement et affinage | Développer des capacités ou adapter un comportement | Modification des poids, préparation et calcul nécessaires |
| Récupération documentaire, ou RAG | Fournir des passages pertinents au moment de répondre | Résultat dépendant de la recherche et du corpus |
| Évaluation | Mesurer exactitude, fidélité et respect des consignes | Test faussé si les exemples ont servi à l’apprentissage |
Cette distinction évite une erreur coûteuse : réentraîner un modèle alors qu’il suffit de lui donner accès aux bons documents.
Choisir un corpus réutilisable, pas seulement téléchargeable
Où chercher selon la nature des données
Les portails publics de données ouvertes conviennent aux statistiques, référentiels et publications institutionnelles. Les catalogues de datasets, notamment sur Hugging Face, facilitent la découverte de corpus textuels, multilingues ou spécialisés. Les dépôts de code peuvent servir à des usages de programmation, mais leur accessibilité publique ne suffit pas à autoriser toutes les réutilisations.
Pour un assistant métier, privilégiez des documents faisant autorité dans le domaine concerné. Un chatbot statistique bénéficie de définitions et de métadonnées explicites ; un outil de traduction demande des textes alignés et représentatifs des langues visées. Un vaste corpus généraliste n’est pas automatiquement préférable à une collection ciblée et maintenue.
Vérifier les droits et conserver la provenance
Examinez la licence du dataset indépendamment de celle du modèle. Vérifiez l’usage commercial, l’attribution, la redistribution et les éventuelles restrictions. Lorsqu’un corpus agrège plusieurs collections, les obligations peuvent différer entre ses composants. Une mention « public » ou « gratuit » ne remplace pas une autorisation de réutilisation.
- Provenance : producteur, méthode de collecte et origine des documents.
- Qualité : langue, complétude, doublons, erreurs d’extraction et actualité.
- Droits : licence, attribution, données personnelles et contenus tiers.
- Maintenance : version, date de récupération et fréquence de mise à jour.
Ajoutez une couche de traçabilité à chaque fragment : document parent, date de validité, licence et identifiant stable. Ce « passeport documentaire » permet de retirer une publication périmée sans reconstruire aveuglément toute la base, puis de retrouver les réponses potentiellement affectées. Le découpage technique ne doit jamais faire disparaître l’identité du document.
RAG ou affinage : adapter la méthode au résultat attendu
Le retrieval-augmented generation, ou RAG, recherche des informations dans un corpus, puis transmet les passages retenus au LLM. Il convient aux assistants documentaires, aux réponses sourcées et aux connaissances régulièrement actualisées. Les documents ne sont pas intégrés aux poids du modèle : ils enrichissent la requête au moment de l’inférence.
Documentation officielle de l’écosystème Hugging Face · Retrouvez les guides, références et documentations API pour utiliser le Hub, les bibliothèques clientes, les modèles, les jeux de données et les Spaces Hugging Face.
L’affinage, ou fine-tuning, adapte plutôt le comportement du modèle à partir d’exemples : respecter un format, appliquer une nomenclature ou suivre un style de réponse. Il ne constitue pas une méthode fiable pour mémoriser puis citer un catalogue changeant. L’entraînement depuis zéro répond à un autre besoin, avec des exigences bien plus importantes en corpus, calcul et expertise.
Une chaîne documentaire reproductible
- Collecter et versionner les fichiers autorisés avec leurs métadonnées.
- Nettoyer les extractions, supprimer les doublons et préserver les titres et tableaux utiles.
- Découper les documents en passages cohérents, sans séparer une règle de ses exceptions.
- Indexer les passages avec des embeddings, des représentations numériques, dans un outil comme Qdrant ou ChromaDB.
- Rechercher et générer une réponse accompagnée de références vérifiables.
Une base vectorielle est une option courante, mais le RAG peut aussi employer une recherche lexicale ou hybride. Pour des chiffres structurés, interroger une base de données peut être plus sûr que rechercher une approximation textuelle. Le modèle explique alors les résultats plutôt que d’inventer une valeur.
Enfin, traitez les documents récupérés comme des contenus non fiables : une instruction malveillante présente dans un fichier ne doit pas remplacer les règles de l’application. Prévoyez aussi une réponse d’abstention lorsque les passages ne permettent pas de conclure.
Comparer les modèles et décider où les exécuter
Les familles Qwen, Mistral, Llama ou DeepSeek peuvent entrer dans une sélection, mais comparez des versions précises, pas seulement des marques. Licence, qualité en français, capacité de génération structurée et besoins matériels varient. Un classement général ne remplace pas un essai sur vos documents.
| Besoin | Critère prioritaire | Test concret |
|---|---|---|
| Assistant documentaire | Fidélité aux passages récupérés | Répondre avec références et reconnaître une information absente |
| Résumé multilingue | Maîtrise des langues ciblées | Préserver les réserves et la terminologie |
| Code et raisonnement | Exactitude vérifiable | Exécuter les tests et contrôler le résultat |
| Déploiement local | Mémoire et latence | Mesurer sur le matériel réellement disponible |
BLOOM illustre un projet multilingue documenté : 176 milliards de paramètres, 46 langues et 13 langages de programmation. Ces caractéristiques décrivent son périmètre, pas une supériorité automatique pour votre application.
API et modèle ouvert ne s’opposent pas. Un modèle à poids accessibles peut être servi par une API distante ou par votre propre infrastructure. L’API hébergée simplifie l’exploitation ; l’auto-hébergement apporte davantage de contrôle, mais impose maintenance, sécurisation et supervision. Ollama ou llama.cpp facilitent certains essais locaux ; vLLM répond à des besoins de service d’inférence.
La VRAM dépend des poids, de la quantification, du contexte et des requêtes simultanées. Une quantification Q4 réduit la mémoire consacrée aux poids sans supprimer les autres coûts. Dans une architecture MoE, peu de paramètres actifs ne signifie pas que seuls ces paramètres doivent être stockés.
Valider un petit périmètre avant d’industrialiser
Commencez par un corpus limité et représentatif, puis préparez des questions accompagnées de réponses attendues et de passages justificatifs. Incluez des informations absentes, des documents contradictoires et des formulations ambiguës. Gardez ce jeu d’évaluation séparé des exemples d’affinage.
Mesurez distinctement la récupération documentaire et la génération : le bon passage a-t-il été trouvé ? La réponse le respecte-t-elle ? La référence soutient-elle réellement l’affirmation ? Suivez également la latence, le coût par requête et le temps nécessaire aux mises à jour.
Pour passer en production, attribuez un responsable au corpus, journalisez les versions et protégez les accès. Des outils comme Langfuse peuvent aider à observer les échanges, à condition de maîtriser les informations enregistrées. La fiabilité vient de toute la chaîne : droits clairs, documents propres, recherche pertinente, modèle adapté et évaluation continue.