Migrer un webhook vers un iPaaS sans perdre d’événements
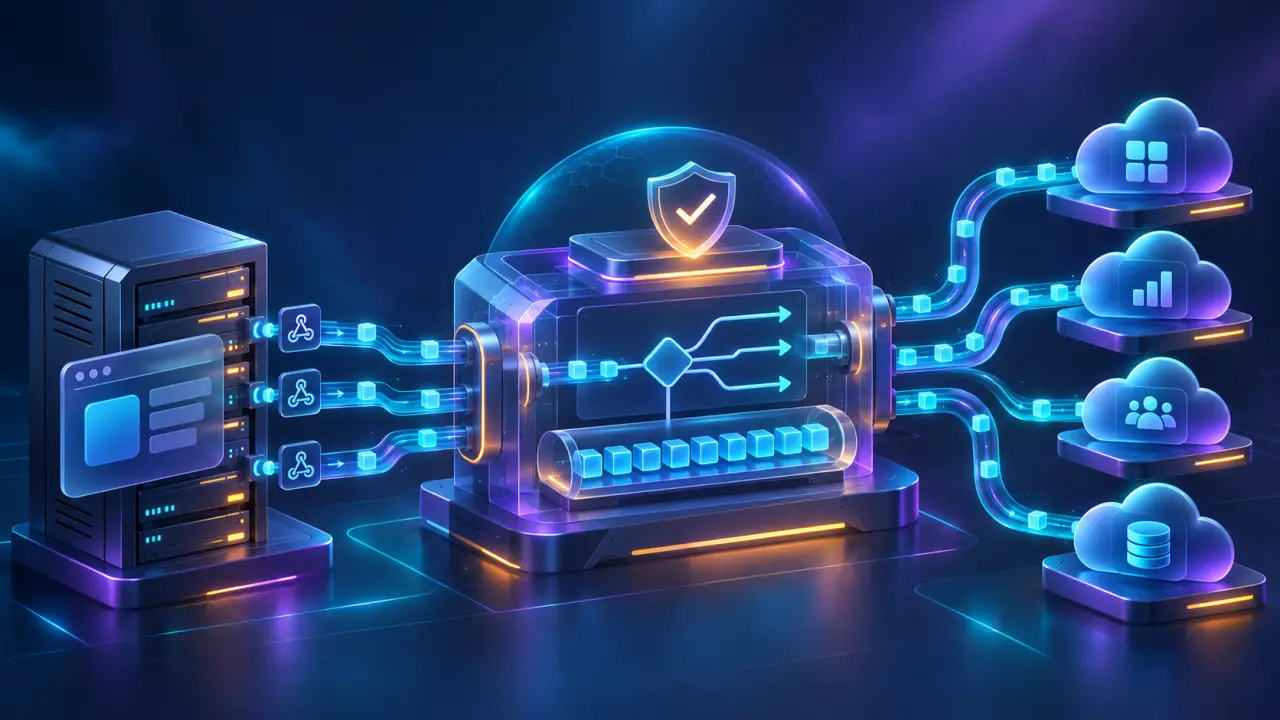
Un webhook maison paraît simple tant qu’il ne tombe jamais en panne. Mais lors d’une migration, chaque notification peut représenter une commande, un paiement ou une mise à jour métier à ne pas égarer. La bonne approche consiste à sécuriser le parcours des événements avant de remplacer le point d’entrée.
Cartographier le flux avant de toucher au code
Commencez par recenser les producteurs, les endpoints, les consommateurs et les transformations appliquées. Pour chaque webhook, notez le type d’événement, le format du corps, les en-têtes de signature, les règles de filtrage et les effets secondaires déclenchés. Identifiez aussi les dépendances peu visibles : délais d’attente, limites de débit, règles de nouvelle tentative ou traitements lancés en arrière-plan.
Cette cartographie permet de comparer le comportement réel du script avec celui que devra reproduire l’iPaaS. Un schéma de flux simple suffit souvent : application source, réception, validation, transformation, puis destination. Ajoutez-y les responsabilités et les mécanismes de reprise. Sans cette base, une migration peut sembler réussie alors qu’un filtre ou une conversion de champ a disparu.
Préparer une réception fiable
Un webhook est généralement livré selon un modèle « au moins une fois » : le fournisseur peut renvoyer un événement si sa première tentative n’obtient pas de réponse satisfaisante. Le destinataire doit donc supporter les doublons. Avant le basculement, définissez une clé d’idempotence stable, par exemple l’identifiant unique de l’événement source, et vérifiez qu’un même événement ne crée pas deux commandes ou deux écritures.
Configurez ensuite la validation de la signature et la vérification des horodatages avant tout traitement. Répondez rapidement avec un code de succès après avoir enregistré l’événement de manière durable, puis exécutez les opérations plus longues de façon asynchrone. Si la destination est indisponible, conservez l’événement dans une file ou un journal consultable plutôt que de le supprimer après une erreur.
Faire cohabiter l’ancien et le nouveau parcours
Évitez de couper le script et d’activer l’iPaaS en une seule opération. Une période de comparaison réduit le risque : le système existant continue d’assurer le traitement principal tandis que le nouveau flux reçoit une copie des événements. Au départ, désactivez les effets secondaires sur le parcours de test afin de ne pas envoyer deux factures, deux courriels ou deux mises à jour.
Comparez les résultats à partir de l’identifiant d’événement, et non uniquement des totaux quotidiens. Mesurez les événements reçus, acceptés, transformés, livrés et mis en échec. Vérifiez également les délais de bout en bout, les champs obligatoires et les cas limites : caractères accentués, valeurs nulles, gros volumes ou événements arrivant dans le désordre.
Cette rigueur de coordination vaut aussi pour un projet d’aménagement intérieur à Orléans et Pithiviers : plans, choix de matériaux, intervenants et finitions doivent rester cohérents malgré plusieurs échanges. De la même façon, une migration bien pilotée conserve un historique clair des décisions et des données transmises entre chaque partie prenante.
Basculer progressivement et prévoir le retour arrière
Une fois les écarts corrigés, transférez le trafic par étapes si le fournisseur le permet : environnement de test, petit périmètre, puis montée en charge. Si vous ne pouvez pas répartir les envois, basculez à une heure calme et gardez l’ancien endpoint prêt à être réactivé. Définissez à l’avance les critères de retour arrière : taux d’échec, hausse de latence, événements en attente ou divergence métier.
Ne supprimez pas immédiatement l’ancien code. Conservez-le désactivé pendant une période couvrant les retards et nouvelles tentatives habituels. Documentez qui peut relancer un événement et comment éviter qu’une relance ne répète une action déjà effectuée. L’accès aux journaux et aux outils de reprise doit être réservé aux personnes qui en ont besoin.
Checklist de bascule
- Les événements sont identifiés de façon unique et les doublons sont sans effet.
- Les signatures sont vérifiées et les secrets sont stockés hors du code source.
- Les tentatives échouées sont visibles, conservées et rejouables.
- Les transformations ont été comparées sur des exemples représentatifs.
- Les alertes couvrent les erreurs, les retards et l’accumulation dans les files.
- Une procédure de retour arrière est testée et attribuée à un responsable.
Surveiller après la migration
Après le basculement, suivez des indicateurs utiles plutôt que de vous limiter à la disponibilité de l’endpoint. Le taux de livraison, l’âge du plus ancien événement en attente, le nombre de tentatives et le délai médian mettent en évidence des problèmes différents. Une alerte sur une file qui grandit permet souvent d’agir avant que les équipes métier ne constatent des données manquantes.
Enfin, centralisez les journaux avec un identifiant de corrélation commun entre la source, l’iPaaS et la destination. Cela accélère l’analyse d’incident et évite de chercher à l’aveugle dans plusieurs outils. Pour découvrir comment BitLien aide à orchestrer ces échanges, consultez notre page d’accueil.
Une migration réussie se vérifie, elle ne se devine pas
Le transfert d’un webhook vers un iPaaS est moins une opération de remplacement qu’une transition contrôlée. L’inventaire, l’idempotence, la comparaison en parallèle et la reprise constituent les protections essentielles contre la perte d’événements. En instrumentant ces étapes et en préparant le retour arrière, vous gagnez en visibilité sans exposer vos processus à une coupure brutale.